


Read the Full Series
This article is one part of a walkthrough detailing how we recreated an NXP i.MX 8M Mini–based computer using Quilter’s physics-driven layout automation.
2026年9月4日、OpenAIはGPT-6 Astraを発表し、同モデルがKiCadでPCBレイアウトを完成させるショーケース動画を公開しました。このクリップは2分54秒の実行を15秒に凝縮した再生で、OpenAIはこれを、部品を配置し銅箔を配線することで回路図を「製造可能な基板」に変えるものだと説明しています。この発表は電気設計のコミュニティで大きな反響を呼びました。Xでのクリップの再投稿は数日で80万回再生を超えました。KiCadフォーラムには1日のうちにスレッドが立ちました。Hackadayは2日のうちに記事を出し、AIは「そのまま動く」基板を設計できるようになったのかと問いかけました。Quilterは数年にわたりAIによるレイアウト自動化に取り組んできたので、この議論に貢献すべきだと自然に考えました。
LLMはハードウェア周辺の作業で確実に上達しています。データシートを読む、回路図を起こす、レイアウト画像をレビューする、そして今やCADツールを操作する。しかしレイアウトそのものは、LLMにとってはるかに難しい問題です。私たちは60年にわたるオートルーターがなぜエンジニアの信頼を得られなかったのかについて書きました。Astraのデモも、同じレンズを通して見る価値があります。
GPT-6 AstraのPCBデモは実際に何を示したのか
Astraの動画は、フロンティアモデルがグラフィカルなECADツール(KiCad)を端から端まで操作する様子を示しました。これは新しく、電子設計の分野でどの研究所が示したものよりも強力なコンピュータ操作の成果です。
発表記事は、ゲーム開発や米国の確定申告書フォーム1040と並べて「回路基板」の例を挙げています。PCB固有のベンチマークは公開されていません。記事の中でハードウェアに最も近い指標はBenchCADですが、これはCADコードを生成してレンダリング画像から3Dオブジェクトを再構成する能力を測るもので、機械CADであって基板レイアウトではありません。PCBの成果は動画1本だけです。
KiCadフォーラムでAstraを擁護した人たちと批判した人たちは、ひとつの点で一致しました。今日、基板に取り組むLLMは、ある擁護者の言葉を借りれば「目隠しと手錠をされたままPCBを作ろうとしている」のであり、解決策は決定論的なツールを与えて指揮させることだ、という点です。自らLLMとKiCadのMCP構成を使っているスレッドの立ち上げ者は、現状を「PCB設計はそこそこだが、高周波信号はいまだにとても苦手」とまとめ、HDIやBGAは「良いとは言えない」と述べています。そしてある設計者の総括が的を射ていました。今週、ネット上の多くの人がオートルーターとは何かを学んだ、というものです。
LLMはより有能なオートルーターなのか
最初の商用オートルーターは1970年代に登場し、1961年にベル研究所のC. Y. Leeが発表した迷路探索アルゴリズムを土台としていました。以来どの世代も、完了率、すなわちツールがデザインルールを破らずに接続したネットの割合で評価されてきました。
エンジニアがその数字を信用しなくなったのには理由があります。基板は100%接続されDRCを通過していても、リターンパスの不連続、不十分なインピーダンス制御、過剰な結合、あるいは実装上の問題を抱えていることがあります。ピンをつなぐことは、期待どおりに動く基板を作ることと同じではありません。
このレンズでAstraのデモを見ると、ネットが接続されていく様子が見えます。Astraは部品の配置も行っており、その点は従来のオートルーターと異なります。しかしOpenAIの説明でいう「製造可能」とは、出力を製造業者に送れるという意味です。デモにも発表記事にも、完成した基板が意図どおりに動作するかどうかを語るものはありません。モデルにはそれを評価する手段がありません。KiCadファイルを生成する処理のどこにも、その回路が何をするのかを計算する部分がないからです。ECADのGUIを操作するLLMは、同じ目標を追う、より有能な操作者なのです。
オートルーター、LLM、物理駆動型AIの比較
観点 | 従来のオートルーター | ECADを操作するLLM(例:KiCad上のGPT-6 Astra) | 物理駆動型AI(Quilter) |
基本的な考え方 | 手作業で調整したヒューリスティクスとルールの優先順位 | GUIやコードインターフェースを操作する汎用言語モデル | 強化学習+古典的ソルバー+計算幾何 |
問題の立て方 | 配置は入力として与えられ、ネットを配線する | GUI上の逐次的な手順:まず配置し、次に配線する | 配置と配線をひとつの結合した問題として解く |
何から学んだか | エンジニアが記述したルール | 公開された文章、コード、そして入手できる公開基板ファイル | 物理に照らして採点される合成学習問題。人間が設計した基板ではない |
物理的な評価 | なし。DRCのみ | 生成の内部にはなし。外部ツールは呼べるが、結果はモデルが解釈しなければならない | 候補生成中にPhysics Rule Checksを実行 |
目的関数 | デザインルールに照らしたネットの完了 | モデル自身が判断するタスクの完了 | DRCと的を絞った電気的検査を通過するレイアウト候補 |
出力 | 結果はひとつ。多くは90%で、後始末に数日 | 1セッションにつき結果ひとつ | ネイティブECAD形式で数十から数百の順位付けされた候補 |
計算資源 | ワークステーション1台 | 大規模だが、1セッションで基板1枚分のトークン生成に費やされる。ECADはローカルで動作 | 多数の候補にまたがる、クラウド規模の並列配置・配線・検査 |
裏づけのある強み | 単純で重要度の低い基板 | 回路図の作成、データシートの読解、部品選定、レイアウトのレビュー | 公表された適用範囲内の高密度基板 |
これが今日の状況であることは認めなければなりません。技術は速く進化しています。LLMは複数のツールを十分うまく指揮することを学び、上記の問題に対処できるようになるかもしれませんし、汎用人工知能(AGI)が到来すれば、こうした問題はまったく違って見えるかもしれません。ただし本稿の執筆時点では、LLMはいくつかの構造的な理由から、PCBレイアウトを解くのにまだ適していません。
なぜLLMはPCBレイアウトを苦手とするのか
配置と配線はひとつの結合した問題である
レイアウトは、絡み合った2つの問題です。配置が各部品の位置を決め、配線がそれらをつなぎます。そして両者は切り離せません。配線してみるまで、その配置が良いかどうかは判断できないからです。従来のオートルーターは配置を固定の入力として受け取って銅箔を引き始め、配線に行き詰まるとフロアプランのせいにして投げ出しました。
KiCadを逐次的に、まず配置し次に配線するかたちで操作するLLMは、この分離をそのまま再現します。KiCadスレッドの複数の声が、配線はそもそも難しい部分ですらないと指摘しました。ある人は配置こそが「難しい問題」だと述べ、それには回路の理解が必要であり、良い配置であれば30年前からオートルーターでも十分に配線できてきたと指摘しました。別の人は、重要なのは部品が「互いにどういう位置関係にあるか」であり、それが配線や現実の物理とどう噛み合うかだと述べています。
学習データが存在せず、ハードウェアのフィードバックループは遅すぎてそれを生み出せない
LLMは公開されたものから学びます。ソフトウェアでは、それは数十年分の公開コードに加えて、バグとその修正という完全なライフサイクルを意味します。ハードウェアにはそれがほとんどありません。あるフォーラム参加者の言葉を借りれば、入手できるPCBのコーパスは趣味の設計に偏っています。「質の高いプロ向けPCBのほとんどは非公開だろう」からです。別の参加者はこう付け加えました。必要なのは良い例だけでなく、悪い例とその修正である。しかし、誤ったフットプリントからクロストークの緩和まで、ハードウェア設計の完全なライフサイクルが公開されている例はごくわずかです。
そうした失敗例が存在しない理由は、それを生成するのが難しい理由と同じです。ハードウェアのフィードバックループは製造の速度で回ります。ソフトウェアが97%の解を許容できるのは、修正を翌日に出荷できるからであり、LLMがコードを得意になったのは、プログラムが誤っていると分かるまでのコストがビルドにかかる時間だけだからです。PCBの問題を見つけるライフサイクルは「実費を伴う製造と実装の時間で測られる」のです。Hackadayのコメント欄のある実務者は、そのコストがどういうものかをこう描写しました。ハードウェアの問題が1年後に表面化すれば、「上司は顧客に嘘をつかなければならず……顧客は裁判に持ち込み、新聞が書き立てる。100%の解を出せという圧力ははるかに強い」。モデルが自らの失敗から学ぶことに依存するアプローチには、その失敗が安価かつ迅速に観測できることが必要です。製造ロットはそのどちらでもありません。
データの希少さよりも根深い問題があります。完璧なデータセットがあったとしても、完成した基板を模倣するよう訓練されたモデルは、学習元の基板に縛られます。学習したどれとも似ていない設計を与えれば、見たことのある最も近い例に頼り、それが正しいとは限りません。DeepMindのAlphaGo Zeroは囲碁のルール以外何も与えずに訓練され、人間の棋譜で訓練した版に100対0で勝ちました。人間のデータで訓練した比較モデルは当初こそ速く学習しましたが、より低い水準で頭打ちになりました(Silver et al., Nature, 2017)。
Quilterのアプローチは後者の道をたどり、同時にフィードバックループの問題も解決します。Quilterは顧客のレイアウトを複製したり、完成した人間の設計を模倣したりして学習するのではありません。システムは、生成した試行、合成の学習問題、レイアウト課題のクラスから学び、それらを物理シミュレーションに照らして採点します。そこでは失敗した候補のコストは製造ロットではなく計算資源です。商用顧客の設計は学習パイプラインに一切使われません。無償版から送られた設計は、設計パターンを再現するためではなく、合成の学習問題を生成するために使われます。
レイアウトは空間的・幾何的であり、これはLLMの実証された弱点である
配置と配線は、制約された2.5次元空間における幾何の問題です。物どうしがどこに位置するか、ビアがどれだけの面積を消費するか、信号の下でリターンパスが保たれるか。これはLLMが力を発揮できない領域です。
GeoGramBench(ICLR 2026)は19のフロンティアLLMを手続き的な幾何推論で評価し、推論志向のモデルでさえ最難関の層では50%を下回ることを見いだしました。2026年の空間イメージ推論に関する研究は、試験したすべてのフロンティアモデルで同じ質的な失敗パターンを見いだし、最良のモデルでもSpatialVizベンチマークで人間の成績に大きく及びませんでした。これまでの研究は一貫した傾向を示しています。LLMは単純な空間タスクではそれなりの能力を見せるものの、構成の複雑さが増すにつれて急速に崩れるのです。
理論を知っていることと、それを適用できることは別である
KiCadスレッドで最も白熱したやり取りは、LLMが「物理を学べる」かどうかをめぐるものでした。一方の側は、フロンティアモデルが高速レイアウトやEMIについて一日中講義でき、アップロードされたレイアウト画像の欠陥を指摘できると、正しく指摘しました。もう一方の側の応答も同じく正しいものでした。「確立された理論を文章で吐き出すことと、その計算や制約を設計に実装することは別物だ」。
LLMの出力はトークンの列です。モデルはもっともらしく見えるレイアウトを生成できますが、もっともらしさは物理と同じではありません。物理がループに入ってこられるのは、モデルが呼び出すツールとしてだけです。そしてモデルはその結果を正しく解釈し、正しく幾何に翻訳しなければなりません。まさにこの2つの工程で、空間推論の限界が効いてきます。
ツール利用の主張にも公平を期しましょう。LLMは、もともと苦手なことをすべてこの方法で扱っています。算術にはPythonを走らせ、事実には検索エンジンを呼び、コードは動くかどうかを考え込むのではなくコンパイルして試します。LLMが同じやり方で電磁界ソルバー、インピーダンス計算機、DRCエンジンを指揮することは十分にありえますし、KiCadフォーラムで最も建設的だった参加者たちはまさにそれを主張しました。ただし考慮すべき点が2つあります。第一に、その時点で物理を担っているのはソルバーであり、LLMに残る仕事は組合せ的な空間の探索と、数値結果の幾何への翻訳です。これは上記のベンチマークが最も弱いと示している2つの能力そのものです。第二に、このパターンが機能すると実証したアーキテクチャは、GUIを操作する汎用LLMではありません。DeepMindのAlphaGeometry(Nature, 2024)は、神経モデルと、各ステップを検証する記号的推論エンジンを組み合わせることで、オリンピアドの幾何問題30問中25問を解きました。それまでの最高水準は10問です。しかもその神経モデルは、人間の証明ではなく1億件の合成例でゼロから訓練されました。AlphaGeometryが機能するのは、各部分が得意なことをしているからです。神経モデルが有望な手を提案し、決定論的なエンジンがその手が本当に妥当かを検証し、モデルは人間の解法を模倣するのではなく合成問題から学びました。Quilterも同様の作りで、PCBレイアウトに特化して最適化されています。強化学習が配置と配線を提案し、ソルバーとPhysics Rule Checksがそれを検証し、学習データは人間の基板から複製するのではなく生成されます。
配線は、後戻りの利かない順序の問題である
Quilterのエンジニア、Fayaz Rahmanはルーターをこう説明します。「ルーターは非常に逐次的で……ある種のバックトラッキングができません」。早い段階の判断が、その後のすべてに使える空間を作り変えてしまいます。電流供給を改善する電源ポアが、後のエスケープ経路を塞ぐことがあります。電流容量を満たす太い配線が、隣接する信号の行き場を奪うことがあります。「順序と制約が、おそらく最も難しいところです」。
強化学習はこの種の問題に適しています。結果が遅れて現れる逐次的な判断を、報酬に照らして評価するからです。基板ファイルをトークンごとに生成するLLMには、3手目の配置判断が300手目の配線可能性に何をもたらしたかを学ぶ、これに相当する仕組みがありません。
AIのPCBベンチマークは実際に何を測っているのか
HackadayはGPT-6 AstraのEEBenchスコアを69.3%(±10%)と伝えており、これはClaude Opus 5とほぼ同水準です。この数字については2つ注意すべき点があります。
第一に、EEBenchはレイアウトを試験していません。その方法論は13のタスクにわたりシミュレーションを通じてアナログ・デジタル回路設計を評価するものであり、著者自身が「モデルが完成品をレイアウトし、製造し、立ち上げられるかどうかは、まだ分からない」と述べています。総合スコアは技術的性能が65%、参照BOMに対するコスト効率が35%です。EEBenchで69%というスコアは、回路図レベルの設計について何かを語ってはいますが、配線についてはほとんど語っていません。
第二に、EEBenchはatopileが構築し資金を出しています。同社の製品は、AIエージェントを念頭に置いた、KiCadで基板を作るためのコードベースのインターフェースです。この点は自ら開示しており、ベンチマーク自体は有用な仕事です。それでもベンダーが公開したベンチマークであることに変わりはなく、その結論の方向性、すなわちモデルはGUIを通じて表現できる以上に電子回路を知っているのだからコードインターフェースを与えよ、という主張は、製品の方向性と一致しています。
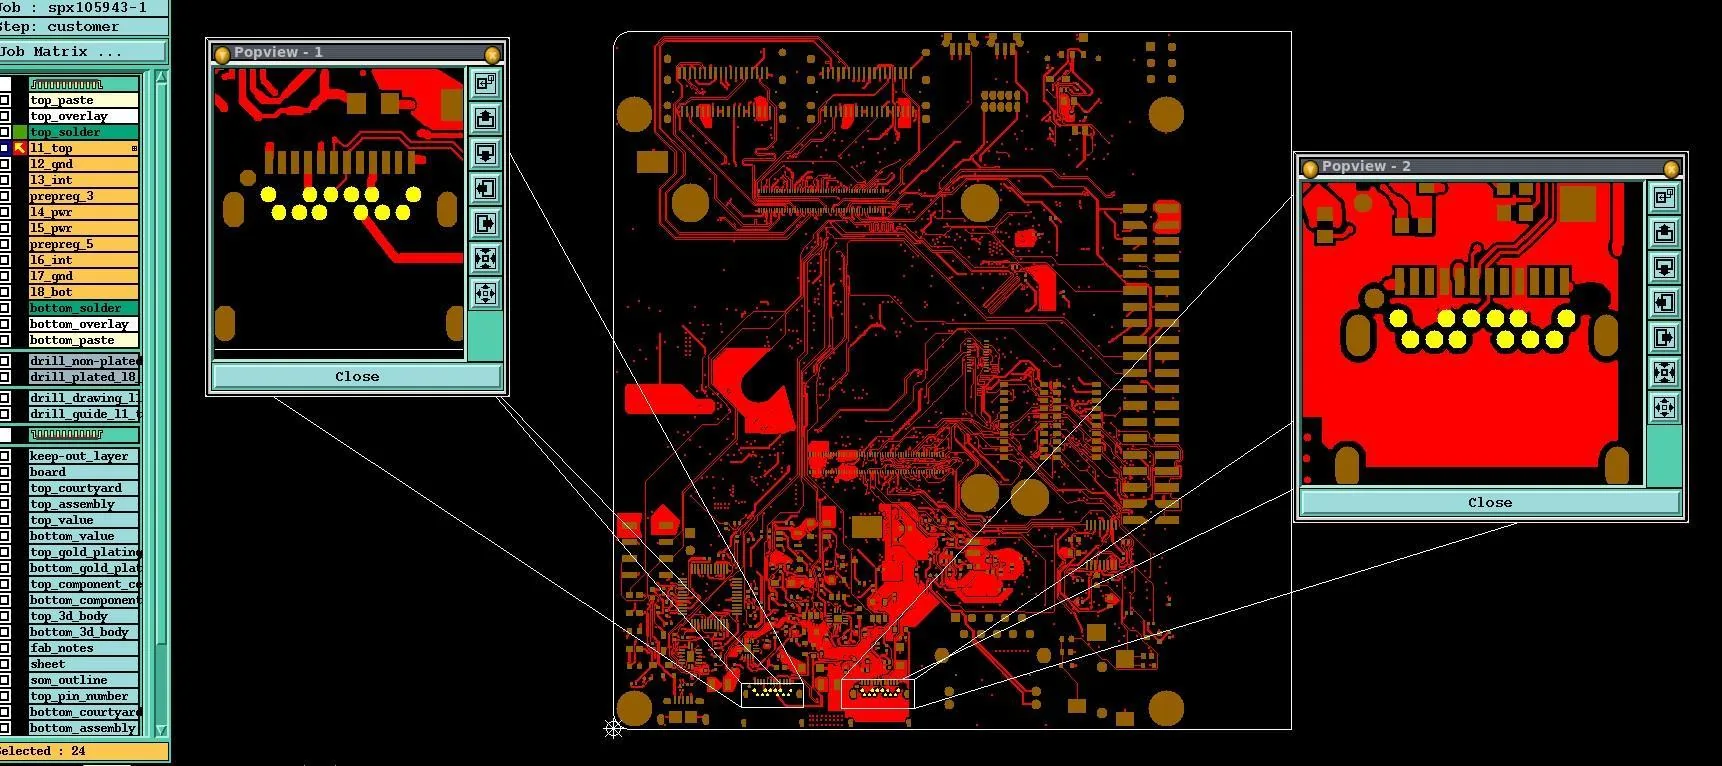
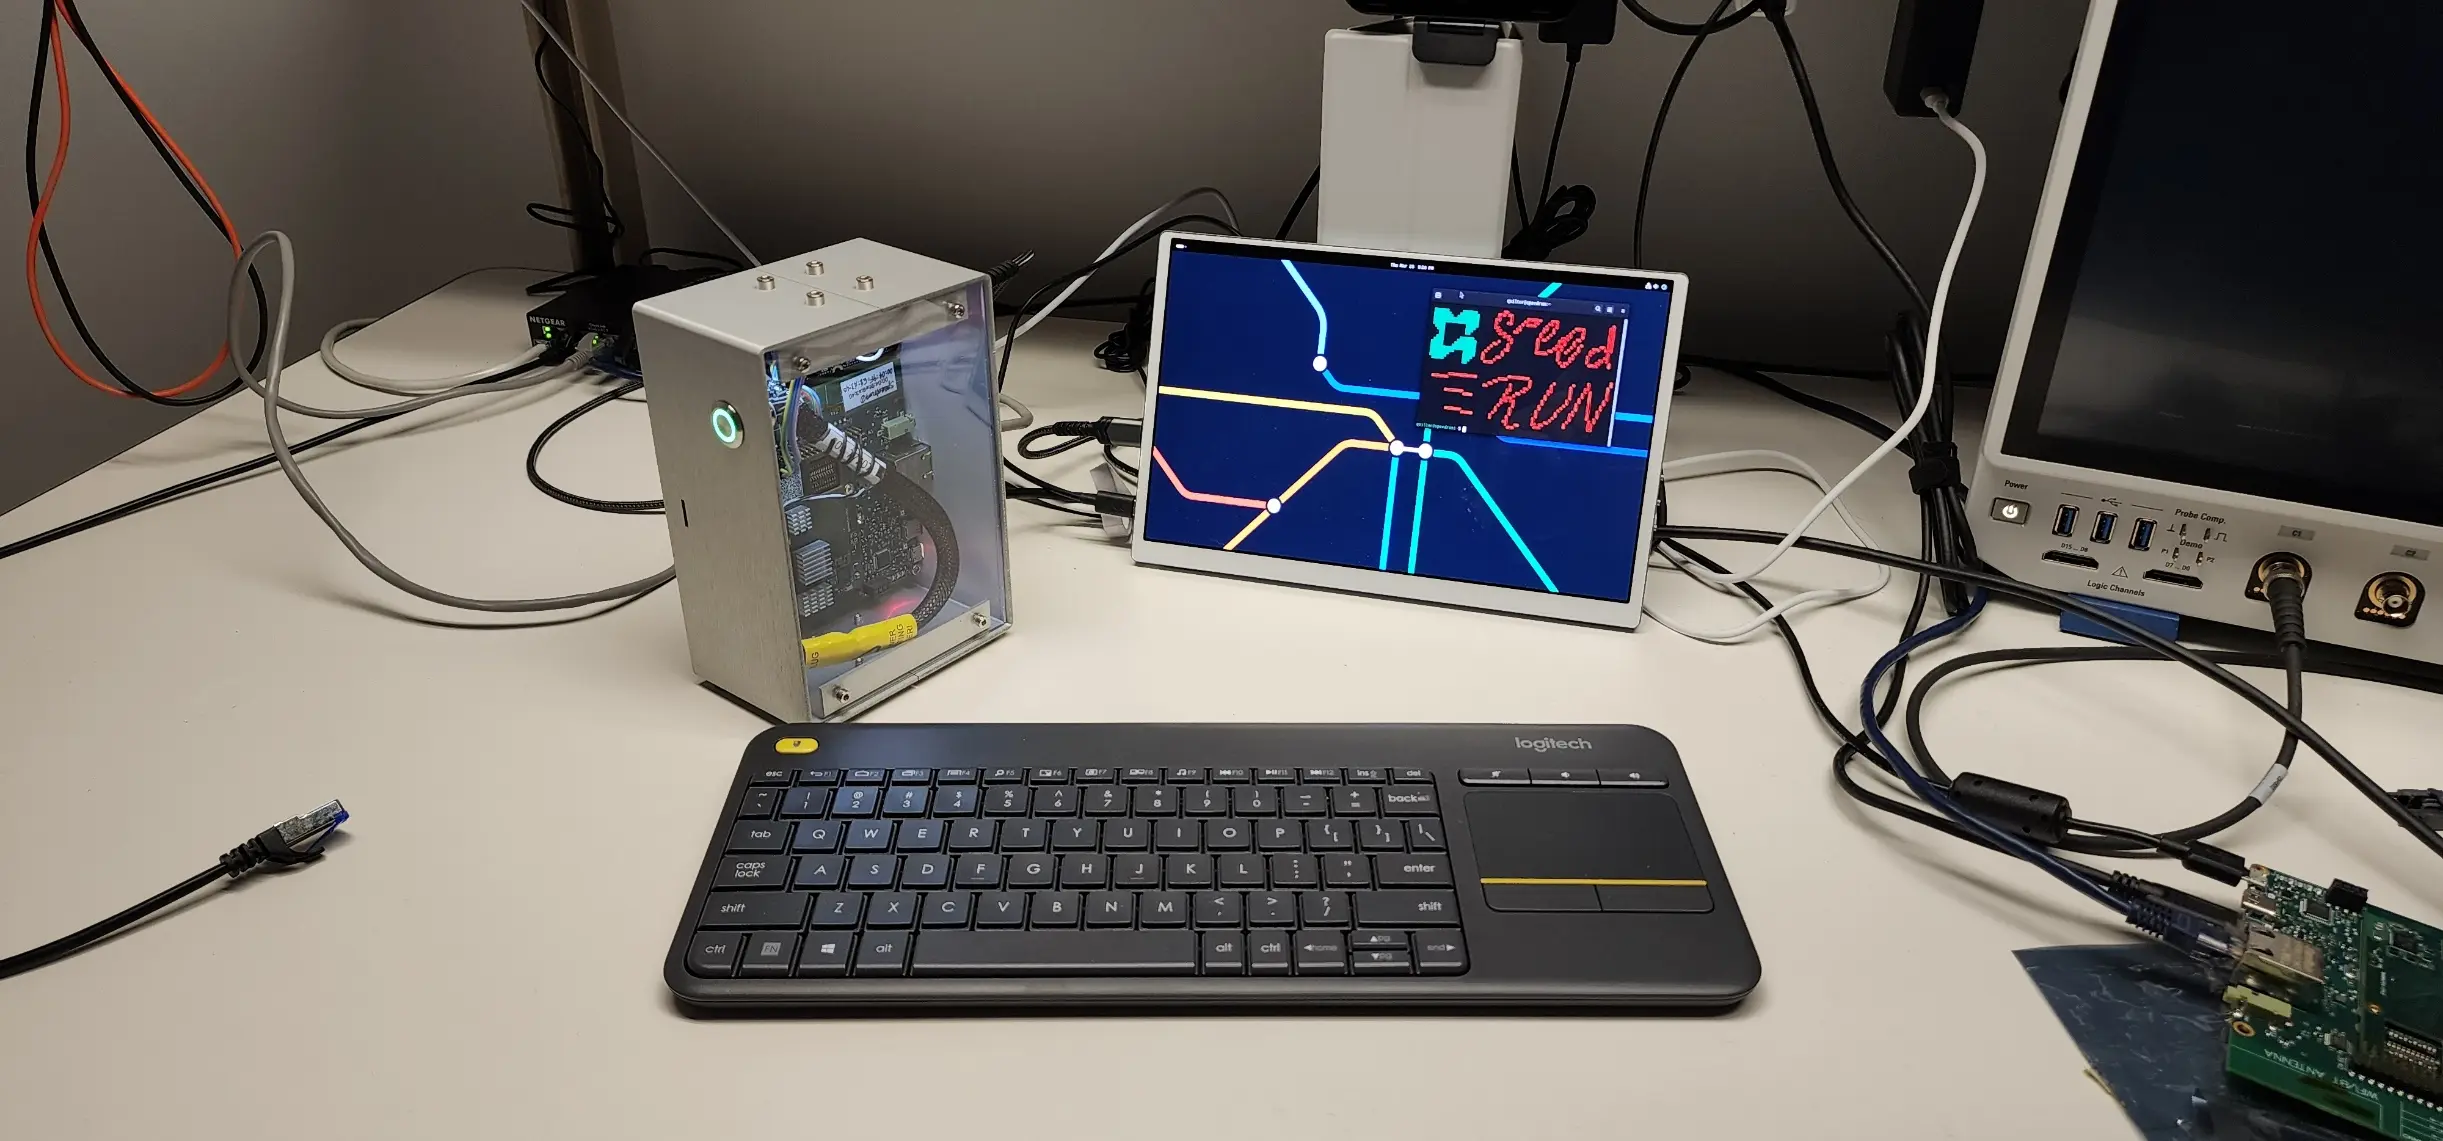
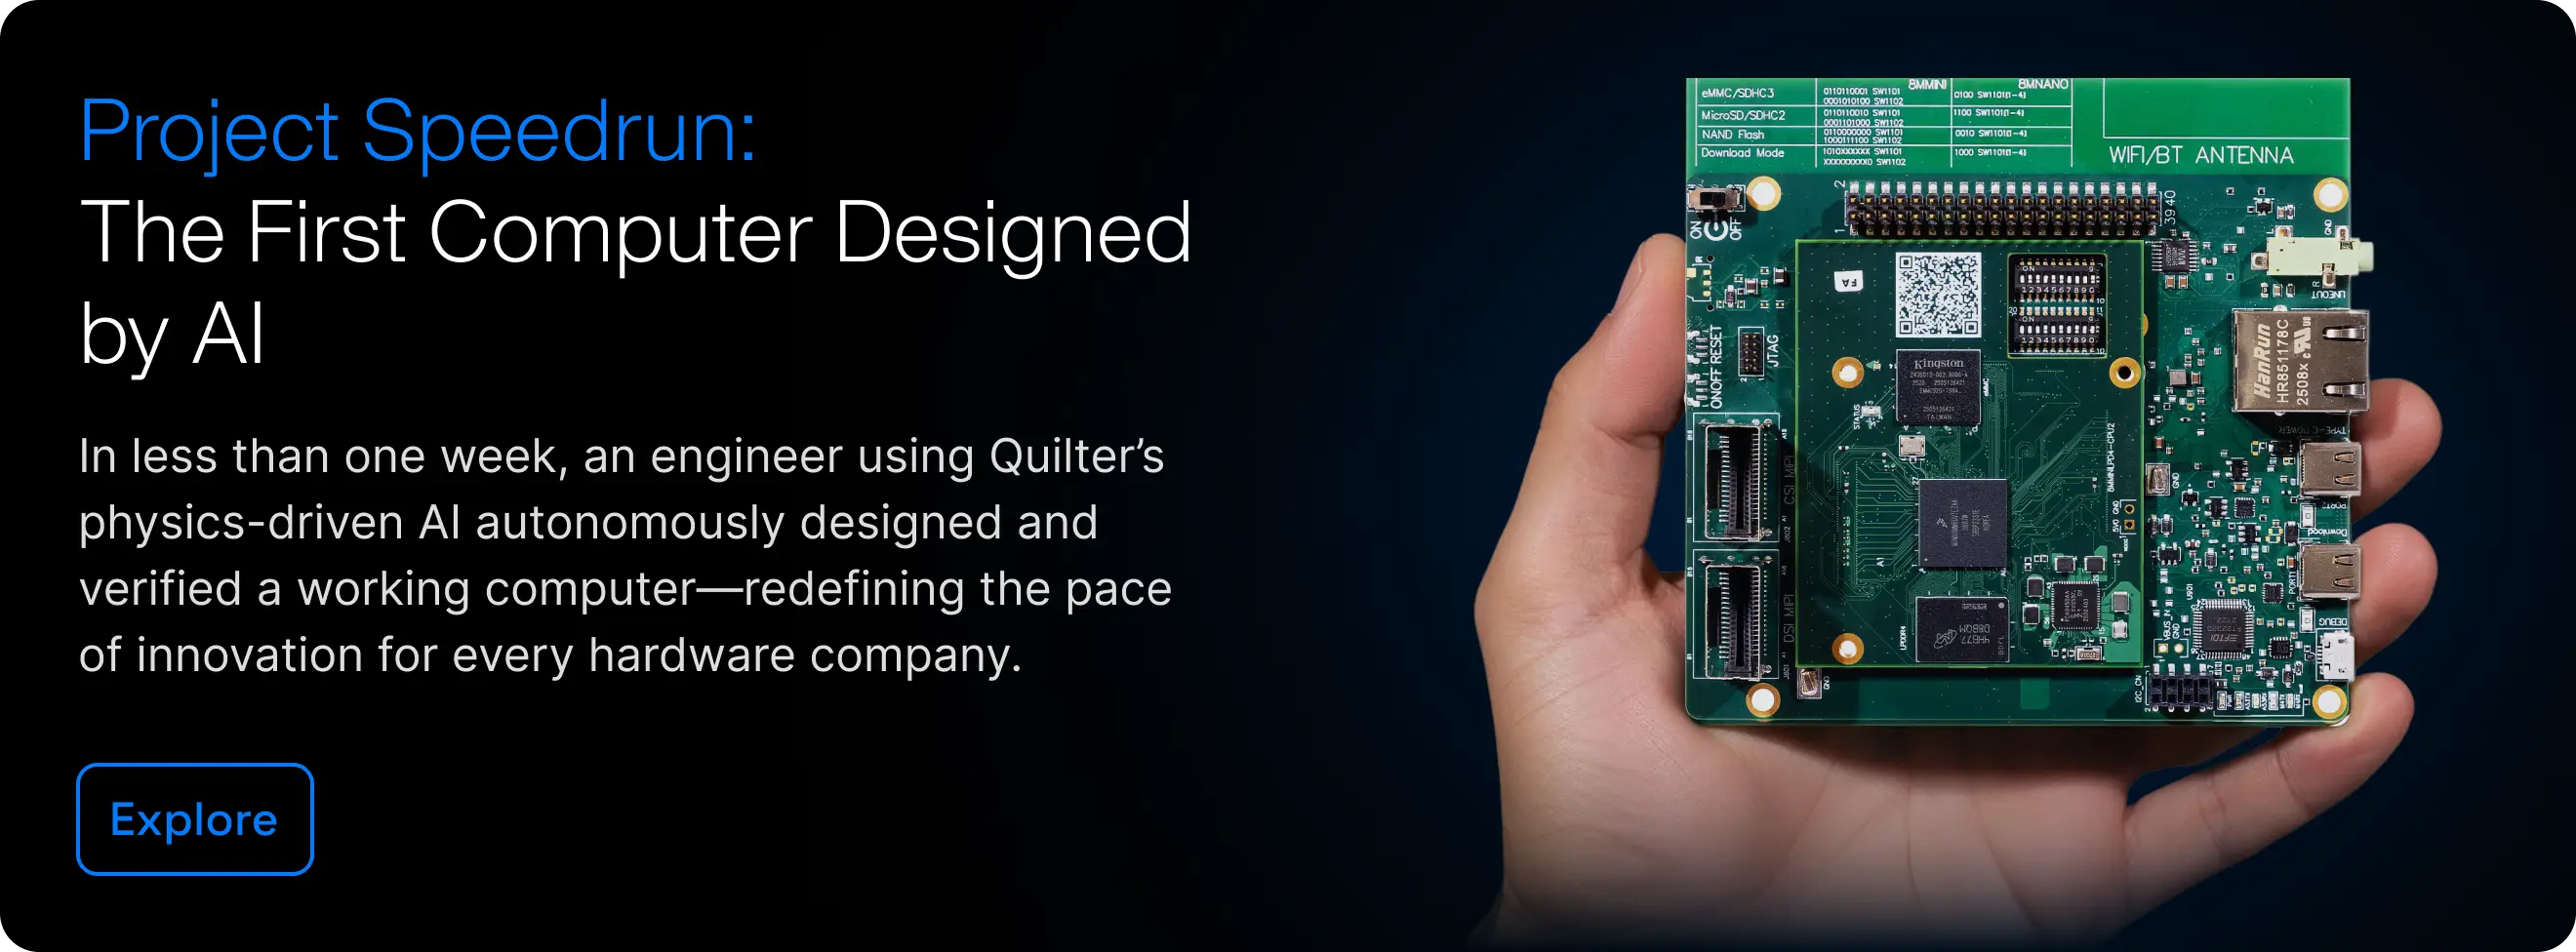
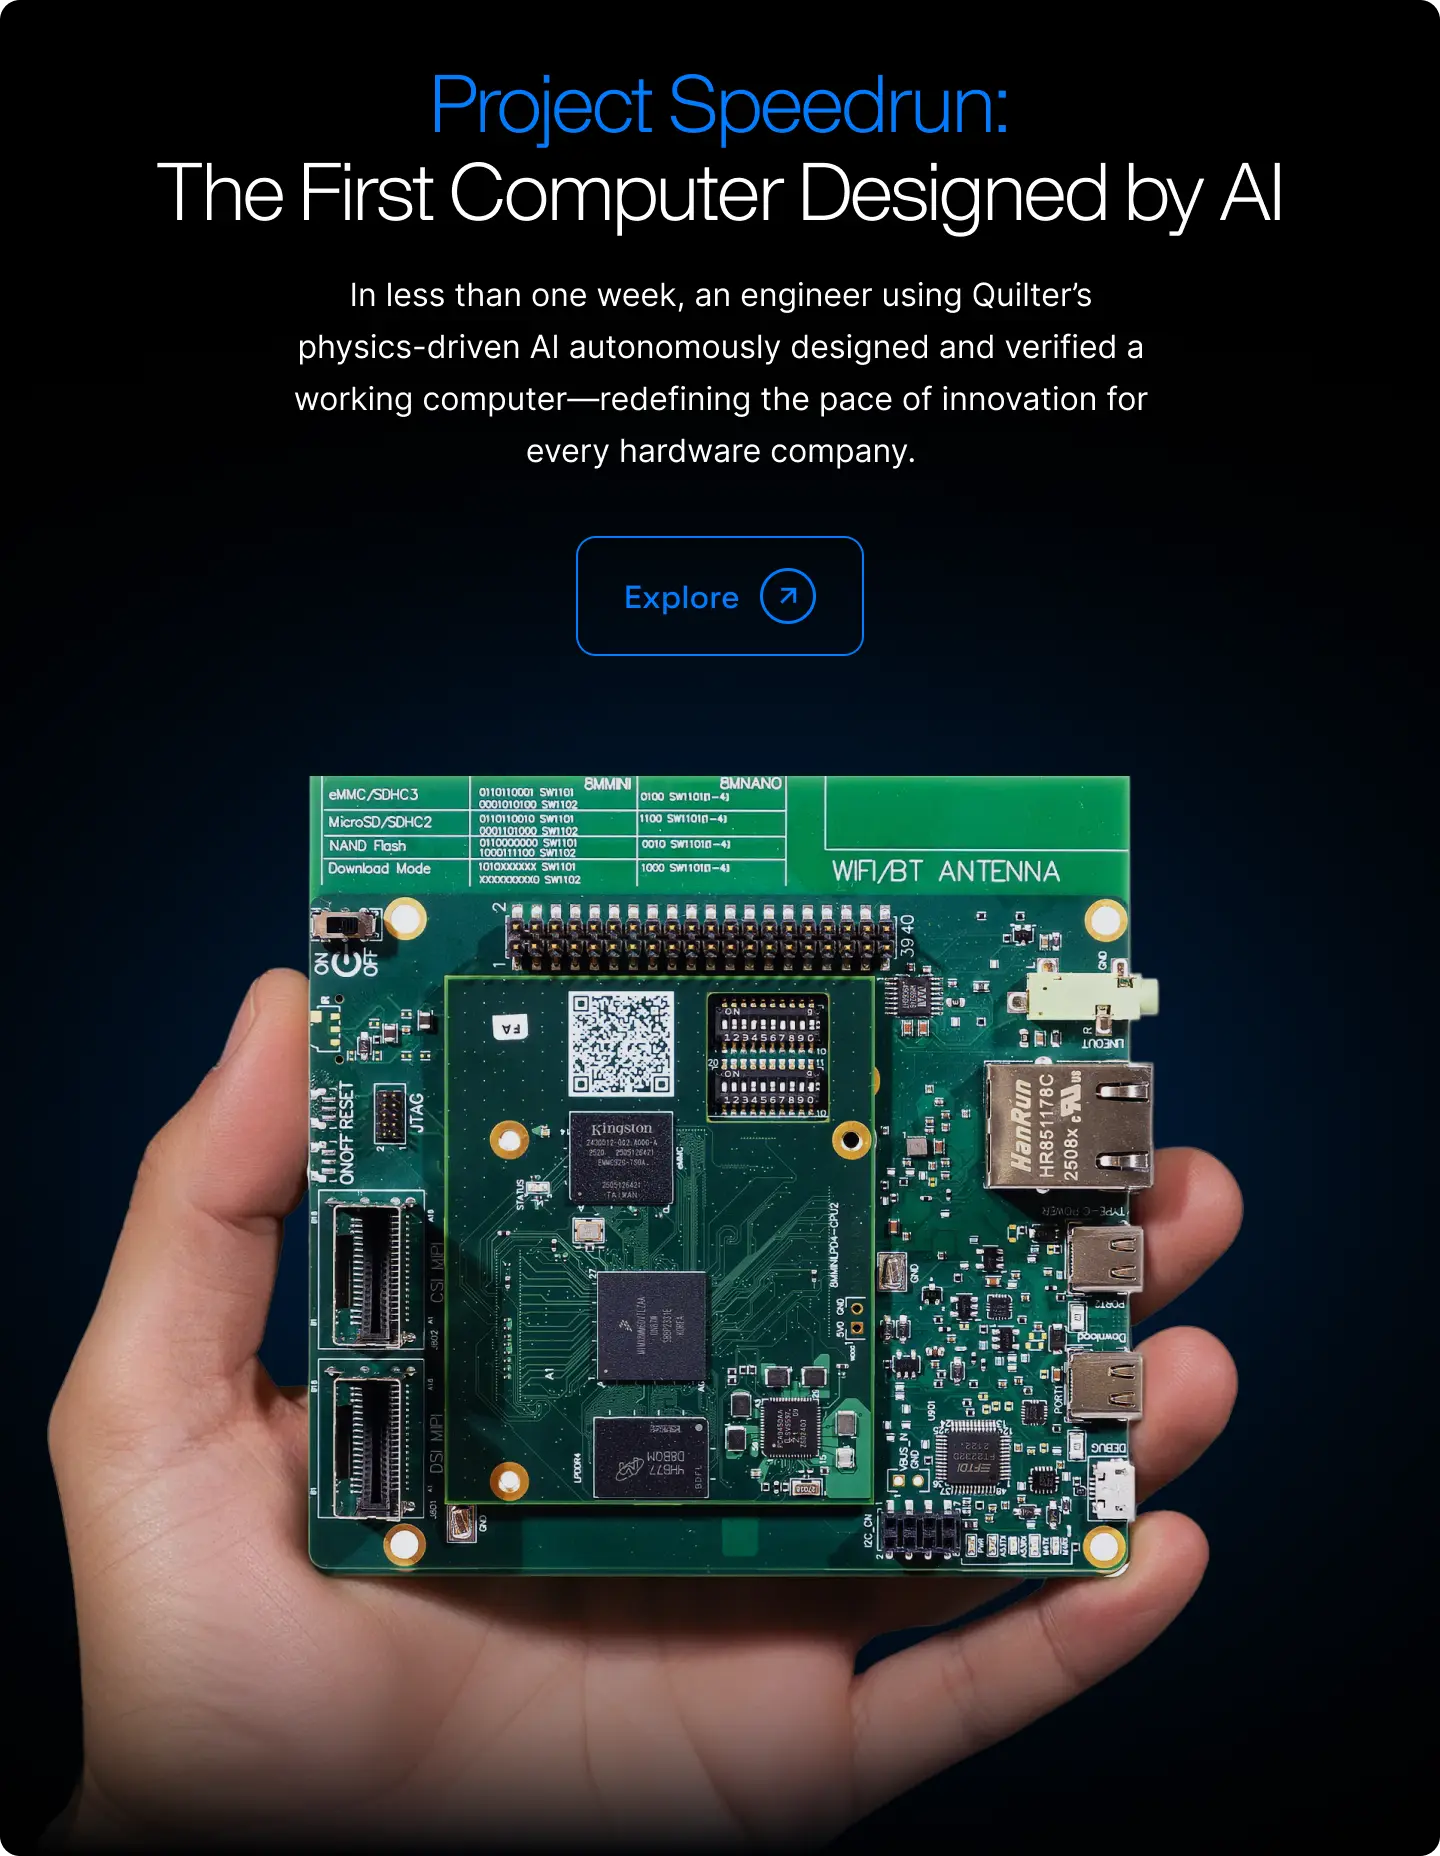
Quilterの論拠もまた自社公開のものであり、読者は同じように差し引いて読むべきです。違いは、それが物理的な検証を伴うレイアウトの結果だという点です。Project Speedrunは、Quilterが配置・配線し、再試作なしで製造された8層のLinux対応マザーボードで、設計データをダウンロードでき、誰でも結果を検証できます。
GUIを操作するLLMに欠けているものは何か
先日のブログで私たちは、オートルーターが失敗したのは3つの具体的な能力を欠いていたからであり、そのいずれもがごく最近になって利用可能になったのだと論じました。KiCadを操作するフロンティアLLMには最初の2つが欠けており、3つ目は、目の前の問題を実際には解決しない形でしか備わっていません。
1. 物理から推論する手段。レイアウトの判断を、固定のルール一覧ではなく、その回路が何をするかに照らして評価することです。Quilterはこれに強化学習を使います。良い基板とは何かを定義し、多数の候補を生成し、それぞれを物理に照らして採点し、どの判断がそこへ至るのかをシステムに学ばせます。
2. 生成中に物理を検査する手段。訓練されたモデルは、有望な判断を提案するのが得意です。しかし、特定の層構成で特定のビア遷移を持つ特定の差動ペアが、公差内でインピーダンス目標に収まるかどうかを計算する道具としては適していません。それは古典的なソルバーの仕事です。Quilterは候補生成の最中にPhysics Rule Checksを走らせます。高速配線下のグラウンドプレーンの被覆、差動ペア間の結合、層をまたぐ際のリターンパスの連続性、その層構成における公差内のインピーダンスです。差動ペアの間隔のように層構成から答えを計算できる場合、Quilterはニューラルネットワークに学ばせるのではなく、ソルバーが出した結果を直接使います。Quilterは単なる訓練済みモデルではありません。探索が難しいところには強化学習を、幾何が探索空間を狭められるところには計算幾何を、物理の計算が必要なところには古典的ソルバーを、厳密な方法が勝るところには厳密アルゴリズムを使います。
3. 探索に振り向けられた大規模な計算資源。Specctra以降のオートルーターはどれもワークステーション1台で動くように作られており、それが、最初の1回か2回の試行から先へ進めなかった最大の理由です。配置がうまくいくかどうかを知る唯一の方法は配線してみることなので、有望な配置は検討の土俵に載せるためだけでも配線しなければならず、多数の候補を配置・配線・物理検査へ並列に流す必要があります。フロンティアLLMに計算資源は不足していませんが、KiCadを操作するLLMはそれを、ローカルで動くECADインスタンス上で、1セッションにつき基板1枚分のトークン生成に費やします。1000セッションを並列に走らせても、1000件の結果を順位付けする物理評価器がなければ何も変わりません。Quilterの計算資源は候補そのものに注がれます。多数の基板について配置、配線、Physics Rule Checksを同時に行うのです。スケーラブルなクラウド基盤の上か、ITAR規制対象の案件であれば顧客自身のAWS、Azure、GCPの中で実行します。
ハードウェアのワークフローでLLMはどこに位置するのか
以上はLLMを電子設計から排除する議論ではありません。フォーラムやHackadayのスレッドは、LLMから実際の価値を引き出しているエンジニアであふれています。データシートからの回路図作成、部品選定と入手性の確認、単純なアナログ段のSPICEシミュレーションの立ち上げ、既存レイアウトの明らかな欠陥のレビューなどです。あるHackadayのコメント投稿者は、ほどほどの規模の基板を3枚「バイブコーディング」で作り、いずれも一発で動いたと報告しています。モデルは従来の設計ツールを通じて示せる以上に電子回路を知っている、というEEBench自身の主張は、それが測っている要件定義と回路図の段階については説得力があります。
レイアウトは、問題が知識の話であることをやめ、物理的制約の下での幾何の話になる段階です。そしてその時点で、汎用モデルはせいぜい指揮者になり、実際の仕事は専用に作られた物理エンジンが担います。
以上のすべての限界を踏まえてもなお、AstraのデモはPCB設計におけるAIの節目です。業界の長年の課題のひとつに、より多くの注目を集めました。そしてそれを通じて、はるかに多くの人がPCB設計というものを知りました。
物理駆動型レイアウトがご自身の基板で何をするのか、ぜひご覧ください。エンジニアにご相談ください。。
よくあるご質問
GPT-6 AstraはPCBを設計できますか。
GPT-6 Astraは、OpenAIの発表動画で示されたとおり、KiCadを操作して回路図から部品を配置し配線を引くことができます。OpenAIはこれについてPCB固有のベンチマークを公開しておらず、デモが示しているのはネットの接続であって、できあがった基板がインピーダンス、リターンパス、信号品質の要件を満たすかどうかではありません。LLM駆動のレイアウトを試したエンジニアは、単純な基板では機能するが、高速信号、HDI、BGAでは苦戦すると報告しています。
なぜLLMはPCBレイアウトが得意ではないのですか。
レイアウトは配置と配線が結合した問題であり、あらゆる判断が電気的な帰結を伴いますが、LLMのトークン生成にはその帰結を計算する部分がありません。またLLMには、非公開であるプロ向けレイアウトの学習データがなく、構成的な空間推論では測定可能なかたちで成績が振るいません。算術にPythonを呼ぶように外部ソルバーを呼ぶことはできますが、その結果を正しく解釈し幾何に翻訳しなければならず、そこが最も弱い部分です。AlphaGeometryやQuilterのように、提案を行うニューラルモデルと決定論的な検証を組み合わせたシステムはこのために作られていますが、GUI上の汎用LLMはそうではありません。
PCB設計において、LLMとQuilterの違いは何ですか。
LLMは、設計ソフトを操作したり基板ファイルを生成したりできる汎用の言語モデルです。Quilterは、強化学習、古典的ソルバー、計算幾何を用いて、配置と配線が揃った候補を生成し物理に照らして順位付けする、専用に作られたレイアウトシステムです。QuilterのレイアウトエンジンはLLMではなく、人間が設計した基板を模倣して学習することもありません。
QuilterはLLMを使っていますか。
QuilterのレイアウトエンジンはLLMではありません。強化学習に古典的ソルバー、計算幾何、厳密アルゴリズムを組み合わせて構築されており、人間が設計した基板やテキストではなく、物理に照らして採点される合成問題で訓練されています。
EEBenchはPCBレイアウトを測っていますか。
いいえ。EEBench V1は13のタスクにわたりシミュレーションを通じてアナログ・デジタル回路設計を評価します。著者自身が、レイアウト、製造、立ち上げはまだ対象外だと述べています。設計ツールのベンダーであるatopileが構築し、資金を出しています。