


シリーズ全体を読む
この記事は、Quilterの物理法則に基づくレイアウト自動化を使い、NXP i.MX 8M Mini搭載コンピューターを再現した過程を詳しく紹介するシリーズの一部です。
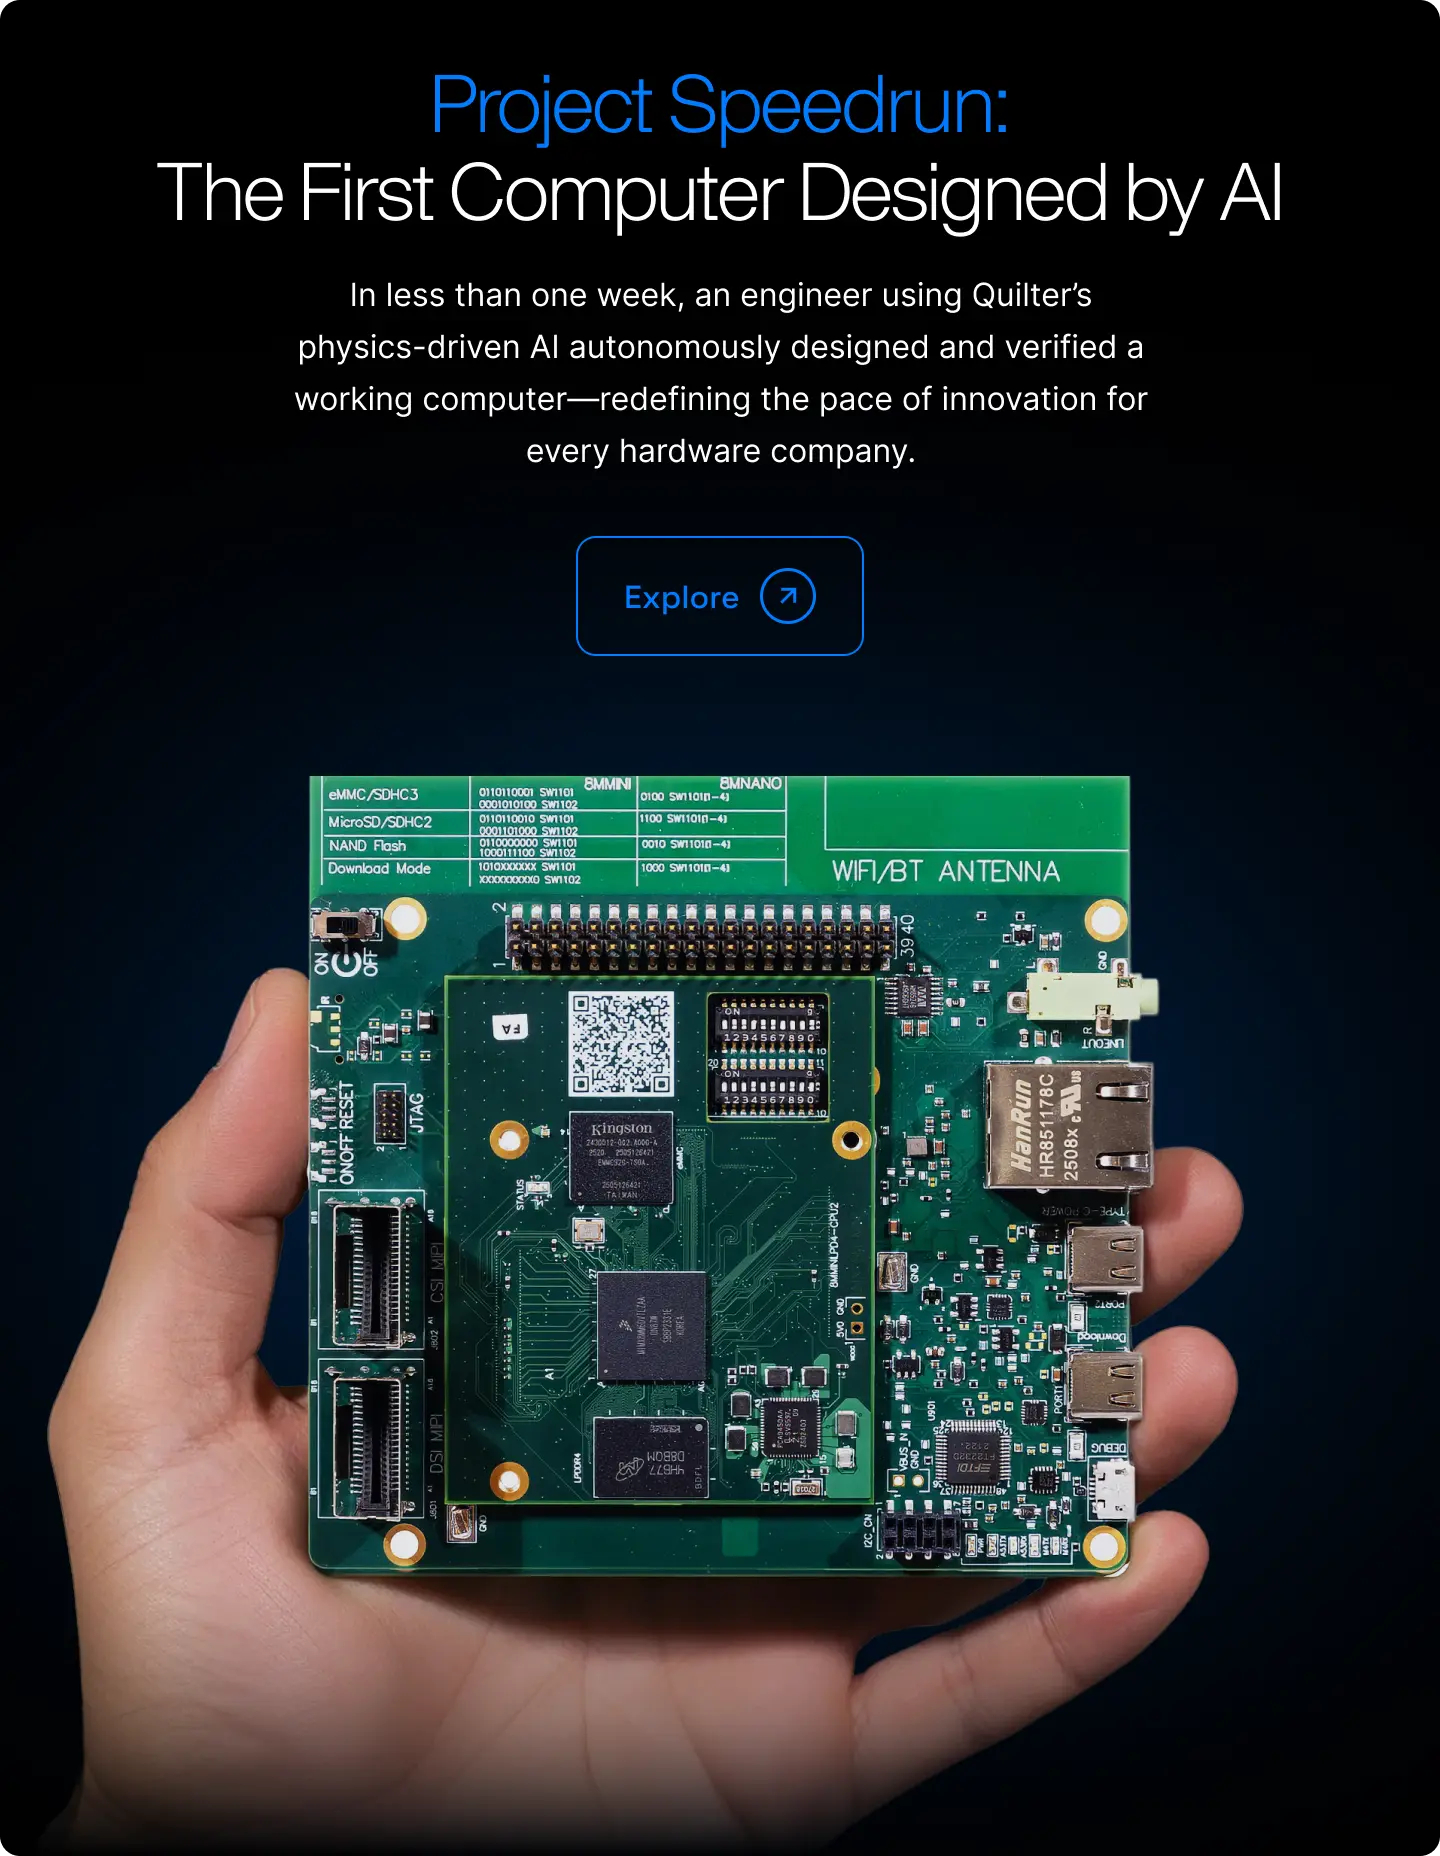
Project Speedrunは、当社の物理駆動型AIを使って1台の完全なコンピューターをできるだけ速く設計するという挑戦です。本ブログシリーズでは、そのシステムがどのように開発されたか、そしてその背後にあるエンジニアリング上の判断を記録しています。まずはProject Speedrunの概要と結果をご覧ください。
ここで使用しているi.MX 8M Miniプラットフォームは、自動車、航空宇宙、産業制御、セーフティクリティカルな製品に搭載されているのと同クラスの基板です。そのため、物理駆動型AIが信頼性の高いハードウェアを実現できるかどうかを試すうえで理想的な題材となります。
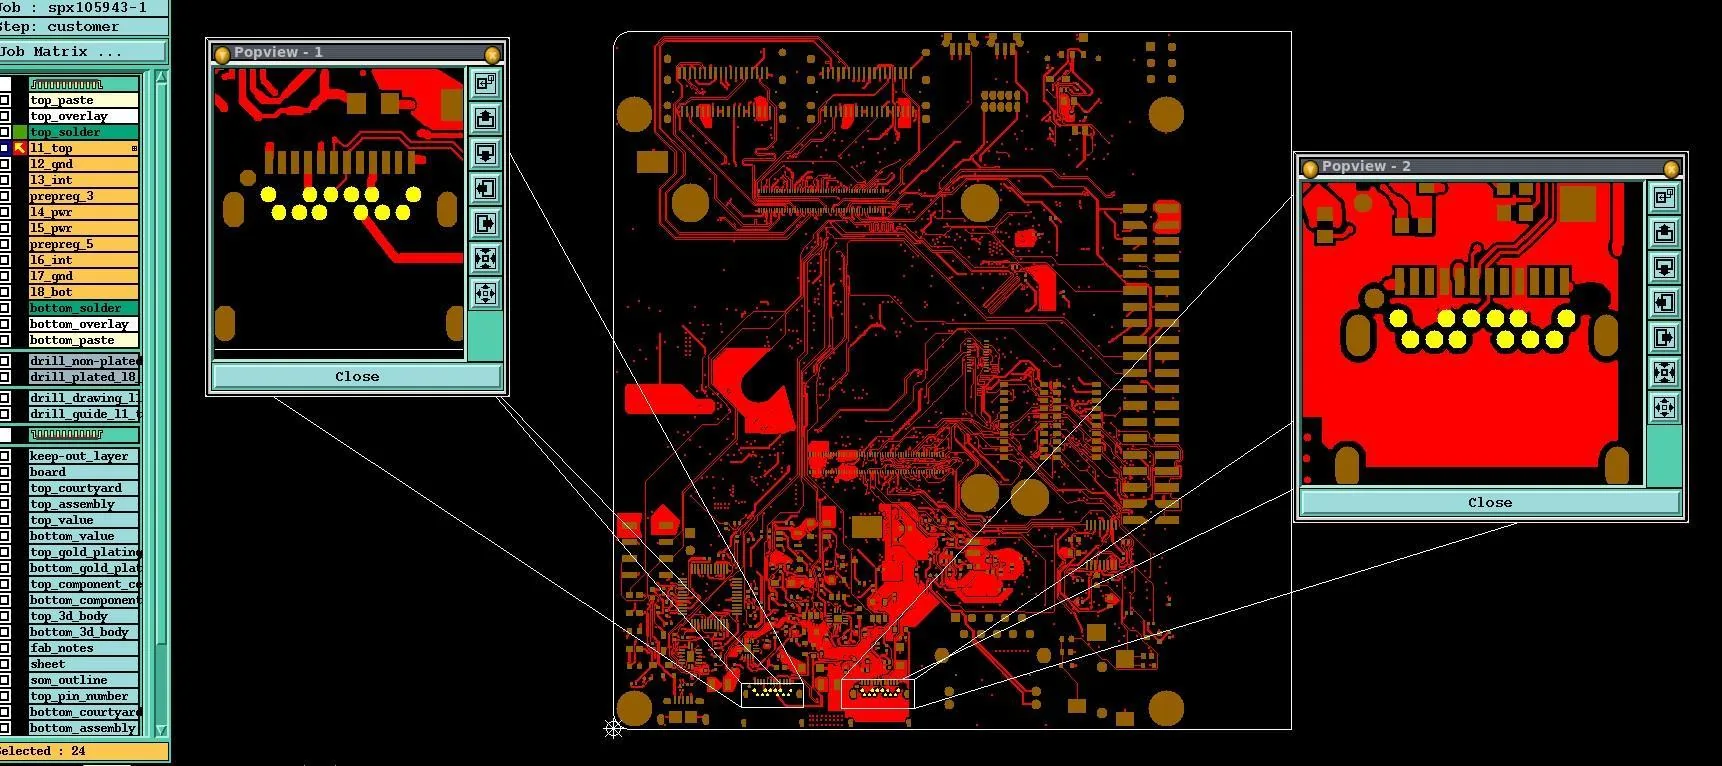
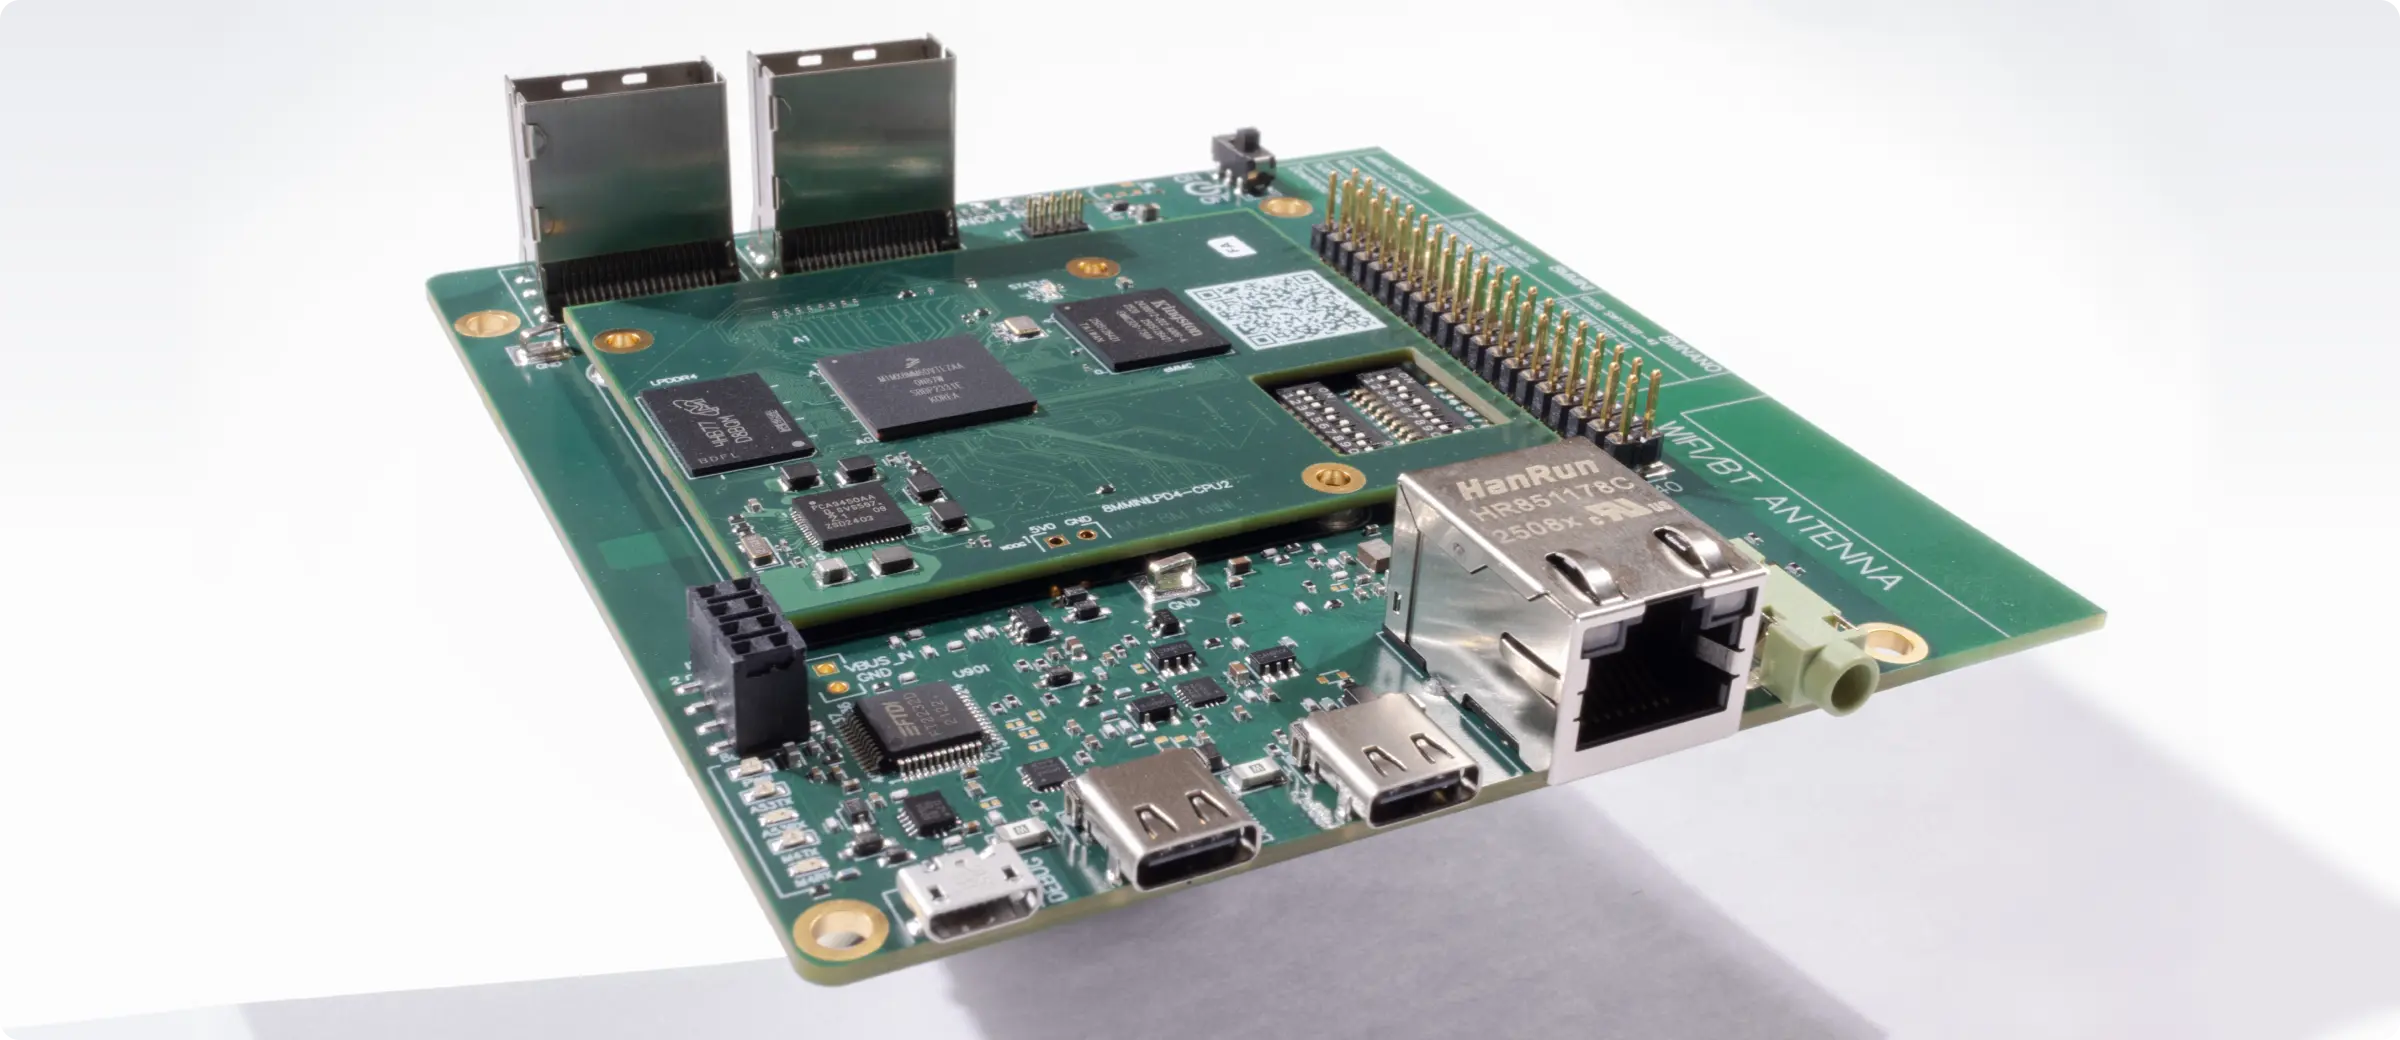
QuilterがProject Speedrun向けに設計した基板は、完全手作業のレイアウトで見積もられた428時間に対し、わずか38.5時間の人手による仕上げで済みました。本当の評価基準はその後に起きたことです。SOMとベースボードはどちらも製造から戻ってくるとすぐに電源が入り、DDRを設定し、eMMCを拡張し、初回試作でシステム全体のワークロードを実行しました。
電源投入:真価が問われる瞬間
電源投入は電気的なミスの多くが表面化する段階であり、正直に言えば、エンジニアが最も緊張し、そして最もワクワクする瞬間でもあります。
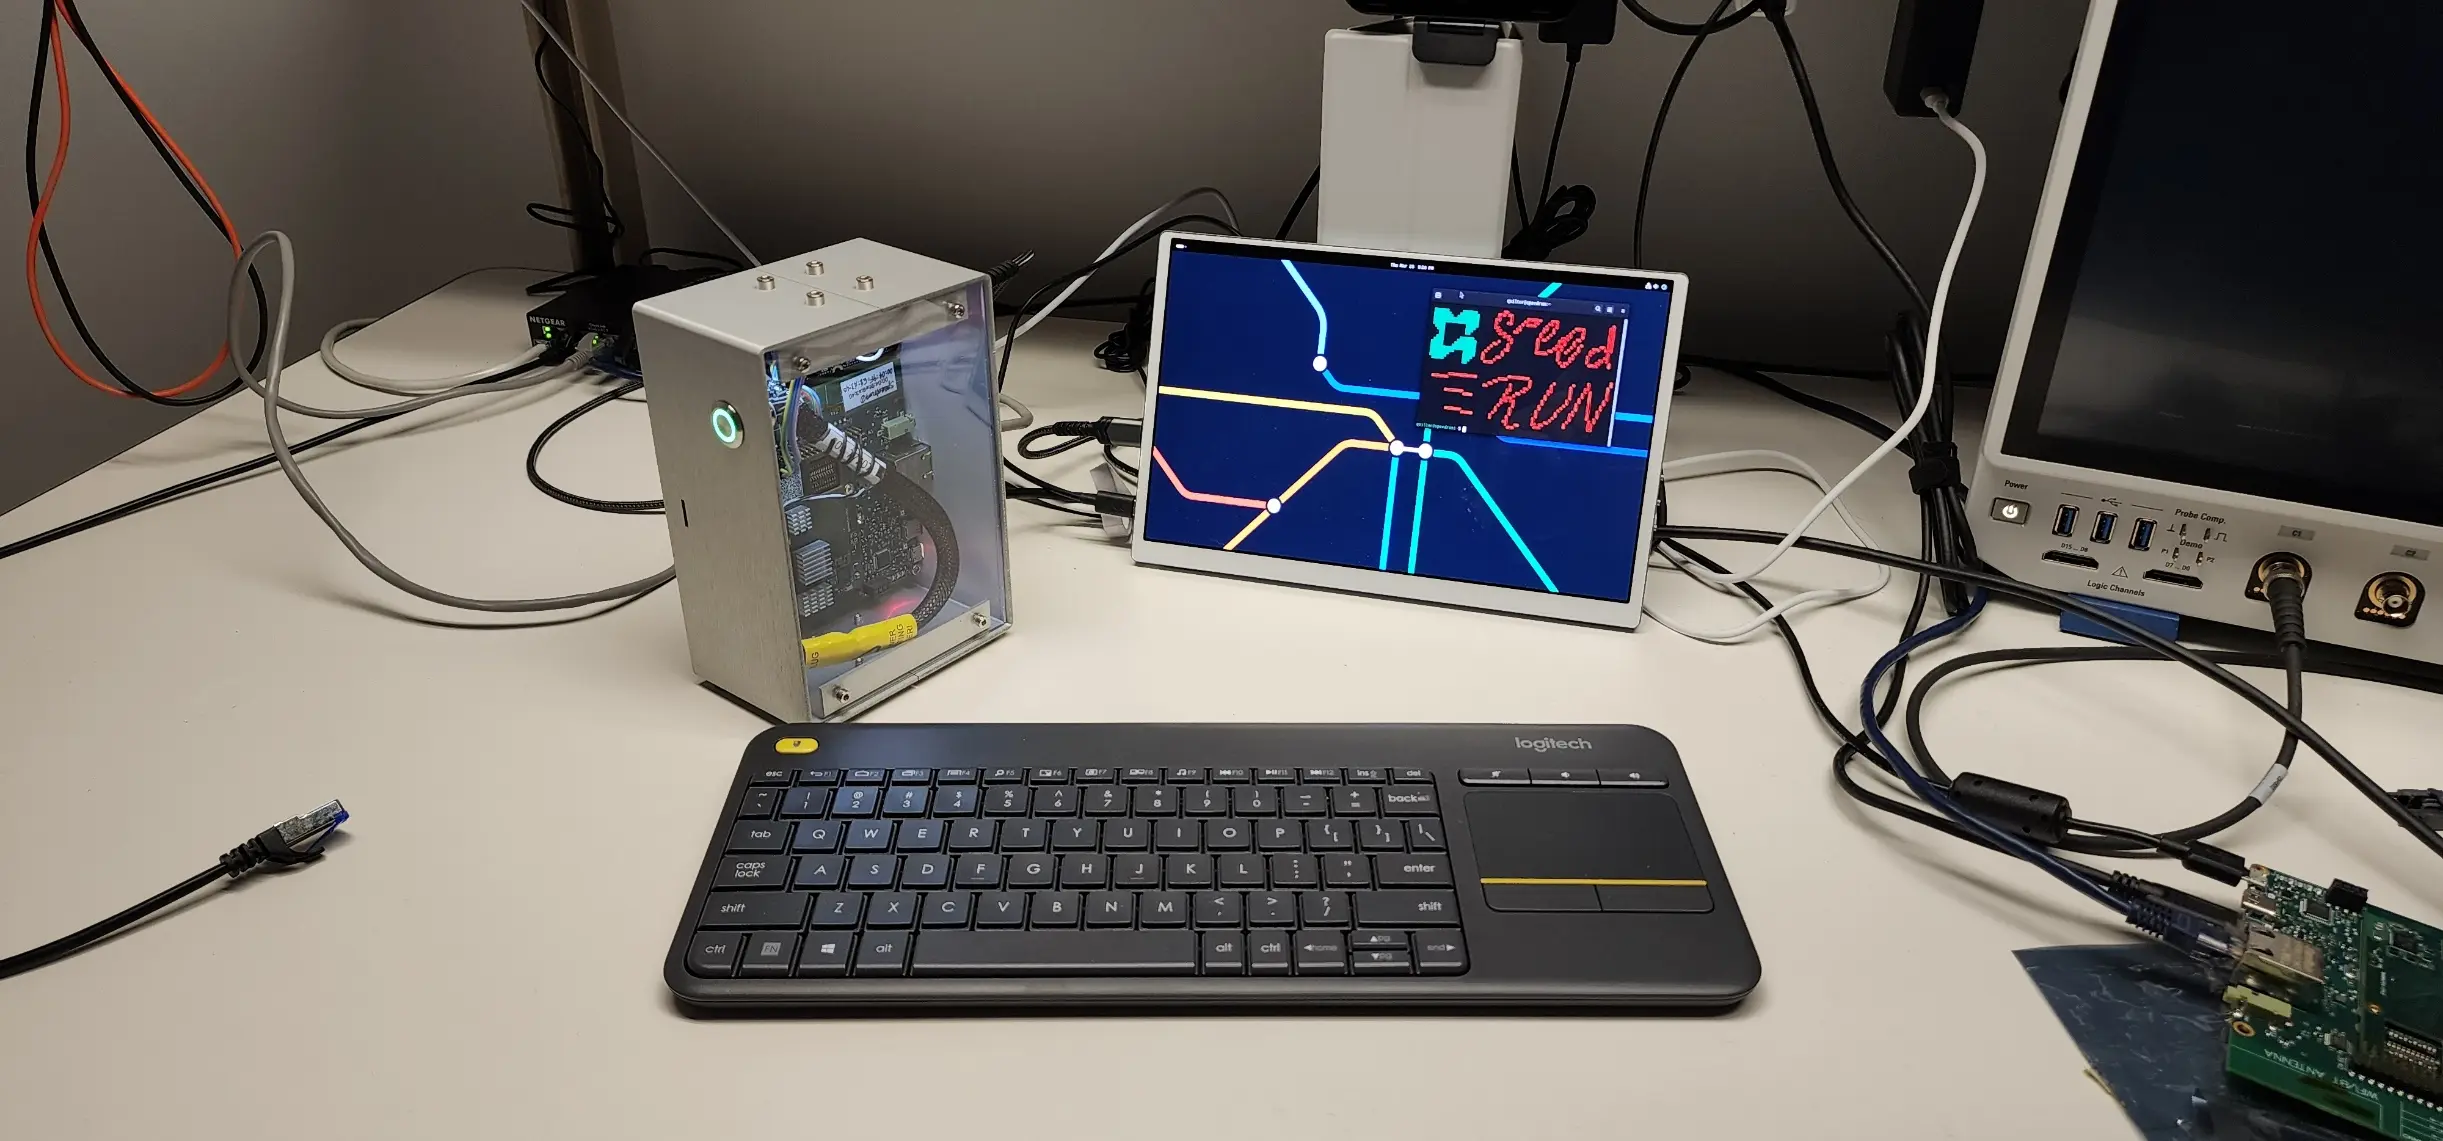
Sierraから基板が届いた瞬間、私たちは一刻も早く動く様子を見たくてたまりませんでした。動作実績のあるNXP EVK SOMを使ってベースボードの検証はすでに済ませていたため、BenはGoogle Meet上で箱を開け、ガレージラボの作業台にカメラを向けながらシステムの電源を入れました。まるでクリスマスの朝のようでした。組み立て済みのSOMとベースボードが机の上に並び、床には帯電防止袋が散らばる、これ以上ないほどクールなガレージラボです。
そのセッションでは、箱から出したばかりの最初の基板を使って、次のことを確認しました。
- SOMとベースボードは問題なく装着できました。
- 電源投入時に発煙、短絡、ブラウンアウトは一切ありませんでした。
- SoCは最初の試行でUSBダウンロードモードに入りました。
- 基板はUSB経由で認識され、書き込みコマンドを即座に受け付けました。
整ったデモを待ちきれない2人のエンジニアが箱を開けて基板をつないだだけでしたが、ハードウェアはあっさりと動作しました。これが重要なのは、実環境で複数のユニットが電源投入を問題なく通過したことで、PDN、大電流経路、デカップリング戦略、シーケンシングが、理想化されたラボ条件だけでなく通常のエンジニアリング作業の中でも十分に機能することが確認されるからです。
ブートチェーンの検証(動作するか?)
コンパイラが信頼されるのは、生成されたプログラムが正しく実行されたときだけです。ここでも同じことが言えます。組込みコンピューターのレイアウトは、起動して実際のソフトウェアを動かせて初めて信頼に足るものになります。
USB書き込み(uuu)
まず、USB 2.0経由でLinuxのフルイメージをSoCに転送し、Universal Update Utility(UUU)を使ってeMMCに書き込みました。これにより、USB PHY、リセット動作、PDNの安定性をテストしました。転送は終始クリーンで、切断もリトライも一度も発生しませんでした。
初回起動
通常ブートに切り替えると、クリーンなシーケンスで起動しました。
- U‑Bootが即座に起動しました。
- LPDDR4が検出され、フルスピードの3GT/sでリンクが確立しました。
- QSPIとeMMCは正常に初期化されました。
- Linuxは警告なしで起動しました。
ログインとファイルシステムの拡張
システムはログインプロンプトを表示して認証情報を受け付け、タイミングやI/Oの不具合なしにルートファイルシステムを32 GBのeMMC全体へ拡張し終えました。これにより、ストレージ配線の安定性が確認されるとともに、基本的な信頼性を即座に確立する、人手を介さない起動の成功が実証されました。
起動時のLPDDR4の挙動
LPDDR4は、他のどのインターフェースよりも確実にSI上の問題を露呈させます。通常、初回試作で成功するようなものではありません。
LPDDR4ホストコントローラーのイコライゼーションとリンクチューニングのアルゴリズムは小さな不完全さを補正できますが、根本的に誤った配線を救うことはできません。DDRのトレーニングがクリーンに完了したこと、つまり即座に検出され、フォールバックなしで完了し、警告なしでLinuxに引き継がれたことは想定どおりの挙動であり、メモリチャネルのタイミング、インピーダンス、ビアの挙動がシステムのSIマージン内に収まっていたことを示しています。
負荷時のシステム全体の統合
各サブシステムが個別に機能することは必要条件ですが、それだけでは不十分です。真の検証は、CPU、DDR、GPU、I/O、PDNが一体となって動作するときに行われます。
ブリングアップ中、システムは以下を同時に処理しました。
- CSIカメラ入力
- LPDDR4バッファリング
- 1080p DSI/HDMI出力
- ギガビットEthernet経由のSSH、USB/COM
- GUIでの対話的な操作
システムは安定して動作しました。リセットもスロットリングもアンダーランもネットワークの停止もなく、しかも重要なのは、これらが単純な機能チェックではなかったことです。現実的な負荷をかけたストレス条件であり、PDNマージン、SIの挙動、メモリコントローラーのタイミングの弱点が通常あらわになるようなシナリオでした。
高速動作と実環境ワークロードにおけるシステムレベルの検証
以下の各ワークロードは、関連する動画やログとともにタブ形式のスクローラーで表示されます。これらのシナリオを合わせて、現実的な使用条件下での電気的な正しさとシステムの安定性が実証されています。
複数基板間の一貫性
複数のSOMとベースボードのユニットが、ブリングアップ中に一貫した挙動を示しました。これは、たまたま出来の良い1台が動作したのではなく、設計そのものが正しいことを意味すると私たちは考えています。書き込み、電源投入、初期段階のログはユニット間で一致していました。
残りの検証と今後の取り組み
Speedrun Computerはブリングアップと実環境のワークロードを通過しましたが、製品レベルの完全な検証はさらに先まで続きます。
- PCIeのリンクトレーニングとスループット
- 熱特性および電力特性の詳細評価
- EMI/EMCスキャン
- 高速SIのマージン評価
- 長期信頼性試験
- より大規模なバッチでのユニット間ばらつき分析
これらのステップは、ミッションクリティカルな用途への展開を準備するチームにとって自然な次の段階です。
初回試作での成功が、自動化で実現できることを裏付ける
Speedrun Computerは、Quilterが複雑な高速ミックスドシグナル設計に対応できること、その時間短縮効果が実際に成り立つこと、そして出来上がったハードウェアが実際のワークロードに耐えることを実証しています。SIマージン評価、PCIe特性評価、長期信頼性といった改善すべき領域も見つかりましたが、いずれも製造やブリングアップを妨げるものではありませんでした。
Quilterを使えば、チームは四半期単位の設計サイクルを、実験・学習・前進を毎週繰り返すループに変えることができます。